Qwen3.8 på Intel Arc B70: Hvorfor din AI føles langsom — og hvordan du måler den rigtigt
Når man kører store LLMs lokalt — fx til kodning med Pi, Open WebUI eller egne scripts — er tokens per sekund det tal, alle citerer. Men det tal lyver ofte. På mit setup med Intel Arc Pro B70 (32 GB VRAM), Qwen3.8-27B i INT4 og vLLM via Docker-image cyspiegel/vllm-xpu-b70 så det sådan ud: serveren genererer tekst med ~38–51 tok/s (decode), mens en agent i praksis kan føles som 2 tok/s (e2e med kæmpe kontekst). Forskellen er ikke mystisk — den er prefill, kontekstlængde og hvad du måler.
Denne artikel samler reelle målinger fra mit miljø og introducerer et lille benchmark-script, du kan køre mod enhver OpenAI-kompatibel vLLM-server. Scriptet ligger i GitHub-repoet.
Setup: hvad der faktisk kører
| Komponent | Valg |
|---|---|
| GPU | Intel Arc Pro B70, 32 GB VRAM |
| Model | Qwen3.8-27B, Quant (Frozenlock GPTQ / INT4-sti) |
| Server | cyspiegel/vllm-xpu-b70, preset int4-mtp |
| API-modelnavn | qwen38 |
| Kontekst (config) | op til 131.072 tokens, FP8 KV-cache |
Det er ikke den fulde FP8-checkpoint fra Hugging Face (~28 GB vægte alene), som på ét kort sjældent giver plads til 128k KV-cache. INT4 + FP8 KV er den praktiske kombination til lang kontekst på 32 GB.
Fire tal du skal kende
Benchmark-scriptet rapporterer flere metrikker end et simpelt curl-stopur:
- TTFT (time to first token) — hvor længe du venter, før det første ord kommer. Det er domineret af prefill: at læse hele prompten / konteksten ind i modellen.
- Decode tok/s — hastighed efter første token, under selve tekstgenereringen. Det ligner mest skrivehastighed på tastaturet.
- E2E tok/s (end-to-end) —
completion_tokens / samlet tid. Ved lang kontekst og kort svar bliver dette kunstigt lavt, fordi TTFT tæller med i nævneren. - TPOT (ms/token) — millisekunder per output-token i decode-fasen. Typisk ~20–24 ms/token svarer til ~40–50 tok/s decode; ved ekstrem kontekst stiger TPOT lidt (fx ~26 ms ≈ 38 tok/s).
Konklusion på forhånd: Hvis Pi eller Open WebUI sender titusindvis af tokens som historik, er oplevelsen “langsom” selv om GPU’en stadig skriver med ~45 tok/s, når den først er i gang.
Fuld suite (kort kontekst og “kodning”)
Kørt med ./bench3.sh all mod qwen38:
| Test | Prompt (tokens) | Decode tok/s | TPOT | TTFT |
|---|---|---|---|---|
| quick | 18 | 51,3 | 19,5 ms | — |
| coding (diff-opgave) | 369 | 46,1 | 21,7 ms | 0,43 s |
| agent (~24k tegn kontekst) | 8.085 | 45,7 | 21,9 ms | 5,4 s |
Decode-hastigheden er stabil omkring 46–51 tok/s — det matcher et simpelt curl-test mod /v1/completions. Det er den hastighed, kortet leverer, når modellen genererer.
Kontekst-stresstest: samme kort, fire prompt-størrelser
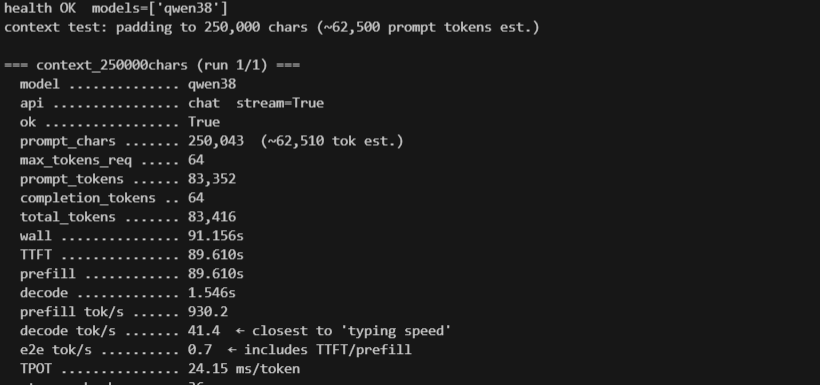
Testen context fylder prompten med syntetisk “åben kodebase”-tekst og beder om ét kort svar (64 tokens max). Formålet er at isolere prefill ved stigende kontekst — som når en coding agent har hele repoet i vinduet.
Kørsel: ./bench3.sh context <tegn> (fx 340000).
| Padding (tegn) | Prompt tokens | TTFT | Prefill tok/s | Decode tok/s | E2E tok/s | Wall tid |
|---|---|---|---|---|---|---|
| ~24.000 (fejl i tidlig script-version) | 8.016 | 5,4 s | ~1.489 | 48,6 | 9,6 | 6,7 s |
| 120.000 | 40.019 | 34,5 s | ~1.159 | 44,0 | 1,8 | 36,0 s |
| 250.000 | 83.352 | 89,6 s | ~930 | 41,4 | 0,7 | 91,2 s |
| 340.000 | 113.352 | 115,9 s (~1 min 56 s) | ~978 | 37,8 | 0,5 | 117,6 s |
Token-tælling kommer fra API’ets usage.prompt_tokens; tegn-padding er ca. 3× tegn per token i disse runs.
Hvad tabellen betyder i praksis
- Decode falder gradvist (49 → 38 tok/s fra lille til ~113k prompt-tokens) — stadig brugbart, men TPOT stiger fra ~20 ms til ~26 ms.
- TTFT vokser næsten lineært med prompt-størrelse: ~35 s @ 40k tokens → ~90 s @ 83k → ~116 s @ 113k — næsten to minutter uden ét synligt ord.
- Prefill-throughput holder sig omkring 930–1.500 prompt-tok/s; flaskehalsen er mængden af tokens, ikke at GPU’en “dør”.
- E2E tok/s på 0,5–1,8 ved 64 output-tokens er forventet matematik, ikke defekt GPU:
64 / 118 s ≈ 0,5 tok/s— næsten al tid er prefill.
Det er sandsynligvis det, du ser, når Pi rapporterer ~2 tok/s: lang tråd + værktøjer + filer, ikke langsom generering.
113k prompt-tokens ligger tæt på min konfigurerede grænse (131.072 max model length). Testen med context 340000 er derfor et realistisk peek på worst-case agent-prefill før decode: ~2 minutters ventetid, derefter stadig ~38 tok/s når teksten først flyder.
Prefix-cache (slået til i min compose) kan gøre gentagne prompts hurtigere; cold, unik mega-prompt er det værste case ovenfor.
Officiel FP8 vs. INT4 vs. GGUF (kort)
| Sti | 128k på 32 GB B70 | Typisk decode |
|---|---|---|
| INT4 + vLLM (mit setup) | Ja, med FP8 KV | ~38–50 tok/s decode |
| Officiel Qwen3.8-27B-FP8 i vLLM | Nej (vægte ~28 GB, KV presset) | ~16k kontekst realistisk |
| Q6_K GGUF + llama.cpp | Muligt, anden stack | Ofte lignende eller lavere end INT4-vLLM ved 128k |
Jeg beholdt CySpiegel-stien til daglig kodning; FP8 er fint til kvalitet ved kort kontekst, ikke som erstatning for INT4 ved 128k på ét kort.
Benchmark-scriptet (bench3.sh)
Scriptet taler med et OpenAI-kompatibelt API (vLLM, llama-server m.fl.) og printer både menneskelæselige blokke og JSON til logning.
Krav
bash,python3,curl- Server kører med kendt model-id (her:
qwen38)
Miljøvariabler
| Variabel | Standard | Betydning |
|---|---|---|
MODEL |
qwen38 |
model i API-kald |
URL |
http://127.0.0.1:8000 |
uden /v1 |
MAX_OUT |
512 |
max completion tokens (agent/coding) |
CONTEXT_CHARS |
24000 |
standard padding til agent / all |
RUNS |
1 |
gentagelser (mean/stdev i summary) |
WARMUP |
0 |
1 = smid første opvarmningskald væk |
FORMAT |
both |
text, json eller both |
Kommandoer
cd ~/vllm-b70
chmod +x bench3.sh

# Fuld pakke: quick, coding, context, agent + summary-tabel
MODEL=qwen38 URL=http://127.0.0.1:8000 ./bench3.sh all

# Enkelttests
./bench3.sh quick
./bench3.sh coding
./bench3.sh agent

# Kontekst-stresstest: andet argument = antal tegn i prompt
./bench3.sh context 120000
./bench3.sh context 250000
./bench3.sh context 340000   # ~113k prompt-tokens, nær 128k-config

# Kun tekst (ingen JSON)
FORMAT=text ./bench3.sh all

# Gentag for stabil median
RUNS=3 WARMUP=1 ./bench3.sh quick
Tests simulerer
- quick — kort completion, ren decode-baseline
- coding — system + kodestump + “lav et diff” (chat, stream)
- context — stor kunstig kontekst + kort svar (prefill-domineret)
- agent — stor kontekst + længere kodgenerering
Kildekode og opdateringer: GitHub — vllm-b70 bench
Tip: I en tidlig version (
bench2.sh) blevcontext 120000ved en fejl stadig kørt med 24.000 tegn. Tjek at output visercontext_120000charsog ~40kprompt_tokens, ikke ~8k.
Pi, Open WebUI og “følt hastighed”
- Peg API mod
http://127.0.0.1:8000/v1og modelqwen38(samme somSERVED_NAMEi Docker). - Mål server med
./bench3.sh quick— forvent ~50 tok/s decode. - Føles Pi langsom: start ny chat, kort prompt; hvis det er hurtigt, er problemet kontekst, ikke GPU.
- Sammenlign decode tok/s fra bench med e2e — agent-brug ligner
context-testen, ikkequick.
Drift: Docker-plads (kort)
Hvis docker pull fejler med no space left on device på /, mens modeller ligger på /home: flyt både Docker data-root og containerd root til /home — billedlag gemmes ofte under /var/lib/containerd på root-partitionen selv om Docker er flyttet.
Opsummering
| Spørgsmål | Svar på mit B70-setup |
|---|---|
| Hvor hurtigt skriver modellen? | ~38–51 tok/s decode (TPOT ~20–26 ms) |
| Kan jeg bruge 128k kontekst? | Ja med INT4 + FP8 KV; ved ~113k prompt-tokens: ~2 min TTFT |
| Hvorfor føles 2 tok/s i agent? | TTFT + kæmpe prompt — e2e 0,5–1,8 i context-test |
| Hvordan dokumenterer jeg ændringer? | ./bench3.sh all og gem JSON |
Hardware og kvantisering bestemmer loftet; kontekst bestemmer, om du rammer loftet eller venter halve minutter på første token. Mål begge dele — decode og TTFT — så du ikke optimerer det forkerte.
Målingerne i denne artikel er kørt på privat Ubuntu-host med Arc Pro B70, oktober 2025. Tal vil variere med image-tag, driver og prompt. Repositér scriptet og rå JSON fra dine egne kørsler sammen med docker-compose for reproducerbarhed.
Ingen kommentarer endnu. Vær den første.
Log ind for at kommentere